 こんにちは。Sun Asterisk AI開発チームです。
マルチモーダルAIは、テキストだけでなく、画像や音声、動画など複数の種類の情報を組み合わせて処理できるAIです。近年は、業務の効率化や顧客対応、商品開発など、さまざまな分野で活用が進んでいます。本記事では、マルチモーダルAIの仕組みや従来のAIとの違い、導入によって得られるメリットを解説します。
具体的な活用事例も紹介するので、自社での導入を検討する際の参考にしてください。
- マルチモーダルAIの定義と従来のシングルモーダルAIとの違い
- 特徴抽出・フュージョン・クロスモーダル処理など、複合データを処理する仕組み
- 画像・音声・センサーデータなどを組み合わせてできること
- 製造・医療・小売など業界別のビジネス活用事例
- 導入メリットと、導入時に検討すべきポイント
マルチモーダルAIの基礎知識
マルチモーダルAIを理解するには、まずどのような情報を扱い、どのように処理するAIなのかを知る必要があります。ここでは、マルチモーダルAIの定義や仕組み、注目されている背景を解説します。
併せて読みたい:生成AIの開発事例|コスト削減や業務効率化に成功した実例を解説
マルチモーダルAIとは
マルチモーダルAIとは、複数の種類のデータを同時に入力・解析し、それらの関係性を踏まえて総合的な出力や判断を行うAIのことです。たとえば、画像とその説明文を同時に理解し、内容に即した回答を生成するような技術が該当します。
生成AIの進化により、テキスト・画像・音声などを横断的に扱えるモデルが実用化されています。
シングルモーダルAI(従来型)との違い
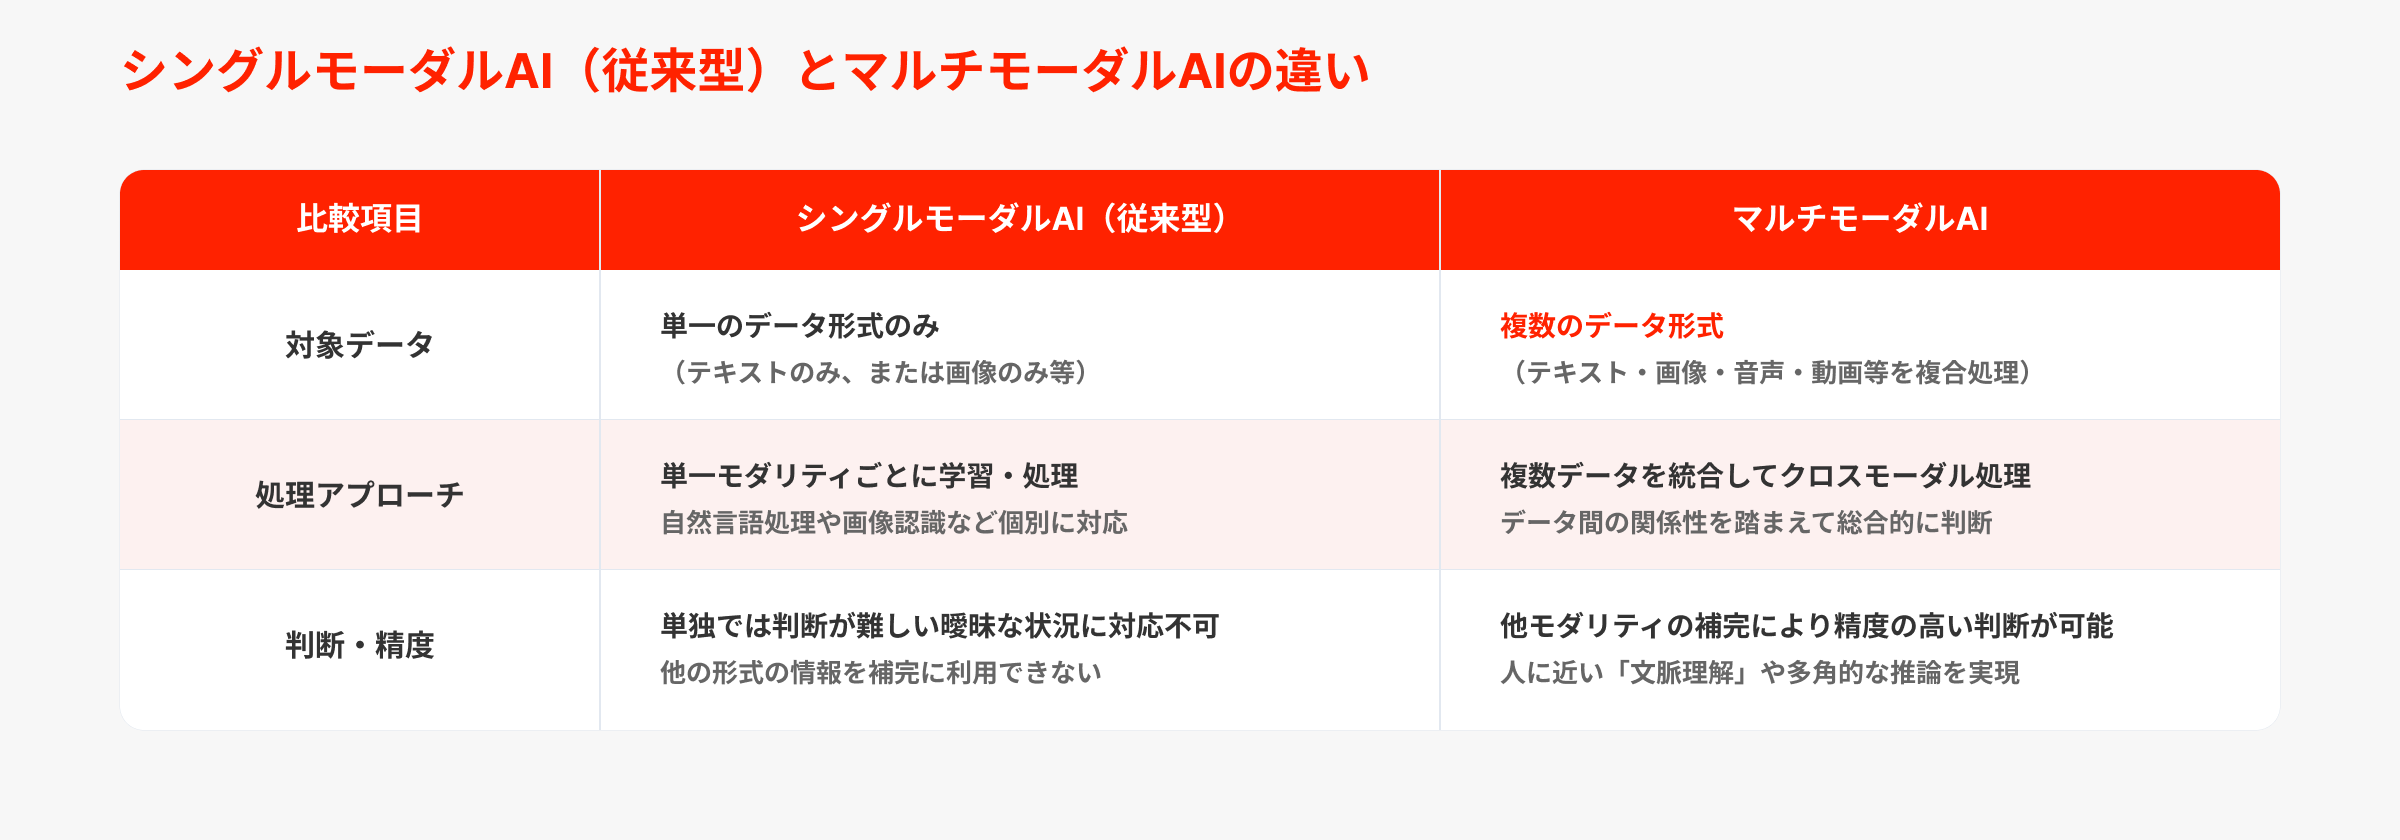
従来型のシングルモーダルAIは、テキストなら自然言語処理、画像なら画像認識というように、単一のデータ形式のみを対象に学習・処理を行います。一方で、マルチモーダルAIは複数のデータを組み合わせて解析するため、単一のデータだけでは判断しにくい状況でも、ほかのモダリティの情報を組み合わせて判断できます。
なぜ今マルチモーダルAIが注目されるのか
背景には、大規模言語モデルや画像生成モデルの発展により、異なる形式のデータを扱う技術が進展したことが挙げられます。また、現実のビジネス課題は音声・映像・センサーデータなど複数の情報が絡み合うケースが多く、単一モダリティでは扱いにくい業務課題への活用が期待されています。
マルチモーダルAIの仕組み(どのように複合データを処理するのか)
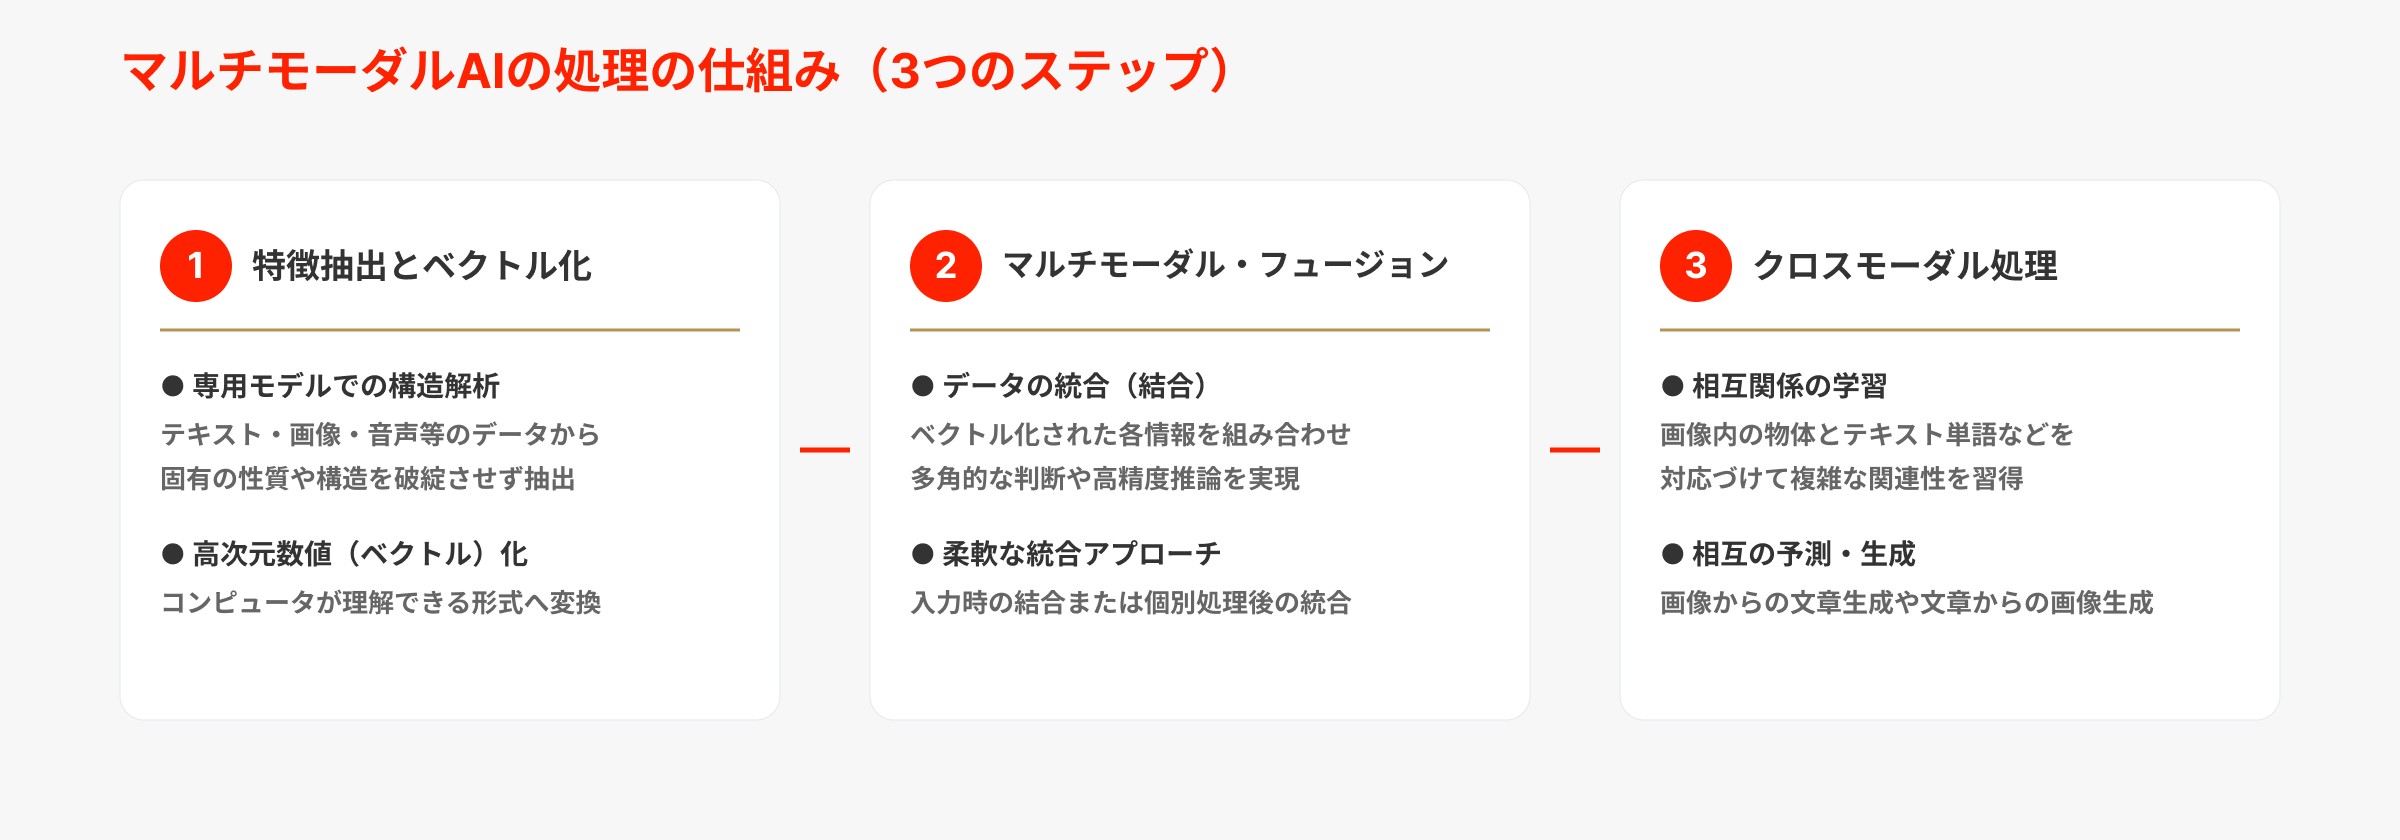
マルチモーダルAIは、テキストや画像、音声、動画など異なる種類のデータを組み合わせて処理し、情報同士の関係性を捉えながら回答や分析を行います。では、複数のデータをどのように理解し、処理しているのでしょうか。
続いては、マルチモーダルAIが複合的な情報を処理する基本的な仕組みを解説します。
特徴抽出とベクトル化
マルチモーダルAIが多様なデータをスムーズに処理するためには、まず画像や音声、テキストなどのデータを、コンピュータが処理しやすい数値表現へ変換します。モダリティごとの特徴を捉えるモデルを用いて、画像や音声、テキストなどのデータを「ベクトル」と呼ばれる数値表現に変換します。
ベクトル化することで、異なる種類のデータを後続の処理で扱いやすくします。
マルチモーダル・フュージョン(データの統合)
ベクトル化された各モダリティの情報を組み合わせる処理は「フュージョン」と呼ばれています。データを入力段階ですぐに結合する方法もあれば、それぞれ個別に処理したあとで統合する方法もあり、取り組むタスクの性質に応じたアプローチが使い分けられています。データを組み合わせることで、単一のモダリティだけでは捉えにくい情報を扱える点が特徴です。
相互関係の学習とクロスモーダル処理
マルチモーダルAIでは、異なるモダリティの情報を関連づけて扱う「クロスモーダル処理」が用いられます。たとえば、画像中の物体とテキスト内の単語を対応づけて学習することで、一方の情報だけで他方の情報を予測・生成することも可能です。
たとえば、画像をもとに内容を説明する文章を生成したり、文章から関連する画像を生成したりする処理にも活用されています。
マルチモーダルAIができること
マルチモーダルAIは、テキストや画像、音声、動画など複数のデータを組み合わせて処理できるため、従来のAIでは対応が難しかった業務にも活用されています。ここからは、マルチモーダルAIによって具体的に何ができるのか、代表的な活用方法を紹介します。
画像・動画 × テキスト(ビジュアル言語処理)
画像や動画の内容を自然言語で説明したり、逆にテキストの指示に基づいて画像を検索・生成したりする技術です。防犯カメラの映像を自動で要約したり、商品画像から詳細な説明文を自動生成したりするなど、視覚情報とテキスト情報を橋渡しする目的で活用されています。
音声 × テキスト(対話・解析)
音声データをテキストに変換するだけでなく、声のトーンや感情、会話の文脈まで踏まえて応答を生成する技術です。コールセンターの応対分析や、感情を考慮した音声アシスタントなど、音声認識に加えて、会話の内容や声の特徴を踏まえた応答に活用されています。
センサー・時系列データ × 映像(行動分析・状態検知)
工場の稼働データやIoTセンサーの数値と、カメラ映像を組み合わせて解析する技術です。設備の振動データと映像を突き合わせて異常の予兆を検知したり、作業員の動きと環境データから安全リスクを評価したりするなど、現場の状態をリアルタイムで把握する用途に活用できます。
業界別|マルチモーダルAIのビジネス活用事例
マルチモーダルAIは、業務内容や扱うデータの種類に応じて、さまざまな業界で活用されています。ここでは、業界ごとにマルチモーダルAIがどのようにビジネスへ活用されているのか、具体的な事例を紹介します。
併せて読みたい:AI活用事例13選|ビジネス課題を解決した企業の実践例を業界別に紹介
製造業|品質検査・設備異常検知の自動化
製造業では、製品の画像データと仕様書、不具合履歴などのテキストデータを組み合わせることで、品質検査や設備保全の高度化が期待できます。たとえば、製品画像と過去の不良レポートをAIで横断的に分析すれば、単なる良品・不良品の分類にとどまらず、欠陥の種類や発生原因の推定、検査結果の説明文の作成などに活用できる可能性があります。
自動車・モビリティ|自動運転・ドライバーモニタリング
自動車分野では、カメラの映像や各種センサー、車両データなどを組み合わせることで、周囲の状況を多角的に把握し、自動運転に必要な認識や判断を支援するために活用されます。また、車内カメラの映像と車両の走行データなどを組み合わせれば、ドライバーの居眠りや脇見などの兆候を検知する仕組みにも応用できるでしょう。
さらに、生体反応データなども分析対象に加えることで、ドライバーの状態をより詳細に把握し、安全運転の精度向上が期待されます。
医療・ヘルスケア|複合データによる画像診断支援
医療・ヘルスケア分野では、レントゲンやCT、MRIといった医用画像と、電子カルテに記録された症状・病歴などのテキストデータを組み合わせることで、高度な診療支援が期待されています。
具体的には、AIが画像所見と患者の既往歴を横断的に分析し、所見文の下書き作成や情報整理をアシストする活用法が考えられます。医療従事者が重要な情報をスムーズに把握できる環境を整え、記録作成をはじめとする業務負担の大幅な軽減にもつながるでしょう。
小売・EC|顧客体験(CX)の高度化と商品推薦
小売・EC業界では、画像と購買履歴、商品レビューなどのテキストデータを組み合わせることで、商品検索やレコメンドの精度向上につながります。たとえば、ユーザーがSNSなどで見つけたコーディネート写真をアップロードすると、AIが画像内のデザインや色、素材感などを分析し、自社ECサイトから類似商品を提案するといった仕組みです。
さらに、購買履歴やレビューの内容も分析に加えれば、ユーザーの好みやニーズに応じた商品や、パーソナライズされた接客などの応用も期待できるでしょう。
セキュリティ・防災|監視カメラ×音声解析
セキュリティ・防災分野では、監視カメラの映像と音声を組み合わせることで、異常を検知しやすくなります。たとえば、映像から人の動きや周囲の状況を分析し、ガラスが割れる音や叫び声なども検知すれば、映像だけでは気づきにくい異常の早期発見につながるでしょう。
このような仕組みは、事故やトラブルへの迅速な対応を支え、被害の拡大防止にも役立つと考えられます。
企業がマルチモーダルAIを導入・実装するメリット
マルチモーダルAIは、複数のデータを扱う業務の効率化やサービスの改善などにも活用できます。ここでは、マルチモーダルAIを導入・実装するおもなメリットを3つ紹介します。
併せて読みたい:業務システム×AI活用ガイド|活用事例と導入計画の立て方を紹介
人に近い「文脈理解」による分析精度の向上
複数のデータを組み合わせることで、単一のデータだけでは捉えにくい状況や文脈も考慮した分析ができます。たとえば、映像だけでは判断しにくい異常も、音声やセンサーデータを組み合わせることで検知しやすくなります。
単一のデータでは見落としていた兆候を捉えやすくなる点は、品質検査や監視業務などで判断の精度向上のポイントです。
複合的な非定型業務の自動化・効率化
テキスト・画像・音声など、複数の形式のデータを扱う非定型業務では、データごとに処理する手間が発生します。マルチモーダルAIを活用すれば、異なるデータをまとめて処理できるため、複雑な業務プロセスの自動化・効率化も進めやすくなります。
その結果、従業員が行う確認や情報整理などの作業を減らし、業務の負担を軽くできます。
既存プロダクトのUI/UX刷新と差別化
音声による操作や画像を使った検索など、テキスト入力だけに頼らないインターフェースを実現できる点もメリットです。ユーザーが音声や画像などを使って操作できるため、従来とは異なるUI/UXを提供し、サービスの差別化につなげられます。
マルチモーダルAIを導入する際の検討ポイント
マルチモーダルAIを導入する際は、活用目的を明確にしたうえで、必要なデータの種類や品質、導入コスト、セキュリティ対策などを確認することが重要です。最後に、自社の課題や運用体制に合った仕組みを選ぶためのポイントを解説します。
併せて読みたい:生成AIの導入ステップと開発コスト相場|構想から運用までの流れを解説
扱うデータとセキュリティ要件を確認する
画像や音声には、個人情報や機密情報が含まれる場合があります。外部のAIサービスを利用する際は、入力データの取り扱いや保存の有無などの利用条件を確認し、自社のセキュリティ基準を満たすかを検証しましょう。
精度と評価方法を事前に決める
複数のデータを組み合わせるほど、どの情報が判断に影響したかが分かりにくくなります。業務で求める精度と評価方法を事前に定め、AIの出力を人が確認する工程も設計しておきましょう。
応答速度とコストを検証する
画像や動画は、テキストに比べて処理するデータ量が大きくなります。リアルタイム性が求められる用途では、応答速度や利用料金が要件に合うかを、実際のデータで検証することが重要です。
小規模なPoCから始める
いきなり本番環境に組み込まず、対象業務を絞ったPoCで効果と課題を確認してから、段階的に適用範囲を広げましょう。
併せて読みたい:生成AIにおけるPoCとは?手順・注意点・外注先選びまで徹底解説
まとめ
マルチモーダルAIは、テキスト・画像・音声・動画など、複数の形式のデータを組み合わせて処理できるAIです。複数のデータを組み合わせることで、非定型業務の効率化や、複数の情報を踏まえた分析に活用できます。一方で、導入にあたっては、自社の業務やデータに適した活用方法を検討しなければなりません。
株式会社Sun Asteriskでは、AIを活用したサービスの構想策定からPoC、本番展開、運用まで一貫して支援しています。マルチモーダルAIの導入やAIを活用したサービス開発を検討している企業は、ぜひお気軽にお問い合わせください。