こんにちは。Sun Asterisk AI開発チームです。
生成AIを業務に活用する際は、機密情報をクラウドへ送信することに懸念を感じる企業もあります。そうした場合の選択肢のひとつが、自社環境でAIを動かすローカルLLMです。本記事では、クラウドLLMとの違いやメリット、注意点、導入方法を紹介します。
- ローカルLLMの仕組みとクラウドLLMとの違い
- 企業がローカルLLMを導入するメリットと注意点
- 業務向けローカルLLMを選ぶ際のポイントと用途別の候補モデル
- ローカルLLMに必要なGPU・VRAM・RAMなどのスペックの目安
- PoCから本番運用まで、ローカルLLM導入を成功させる手順
ローカルLLMとは?
ローカルLLMは、自社のパソコンやサーバーなどでLLMを動かす仕組みです。ここでは、クラウドLLMとの違いを解説します。
クラウドLLMとの違い
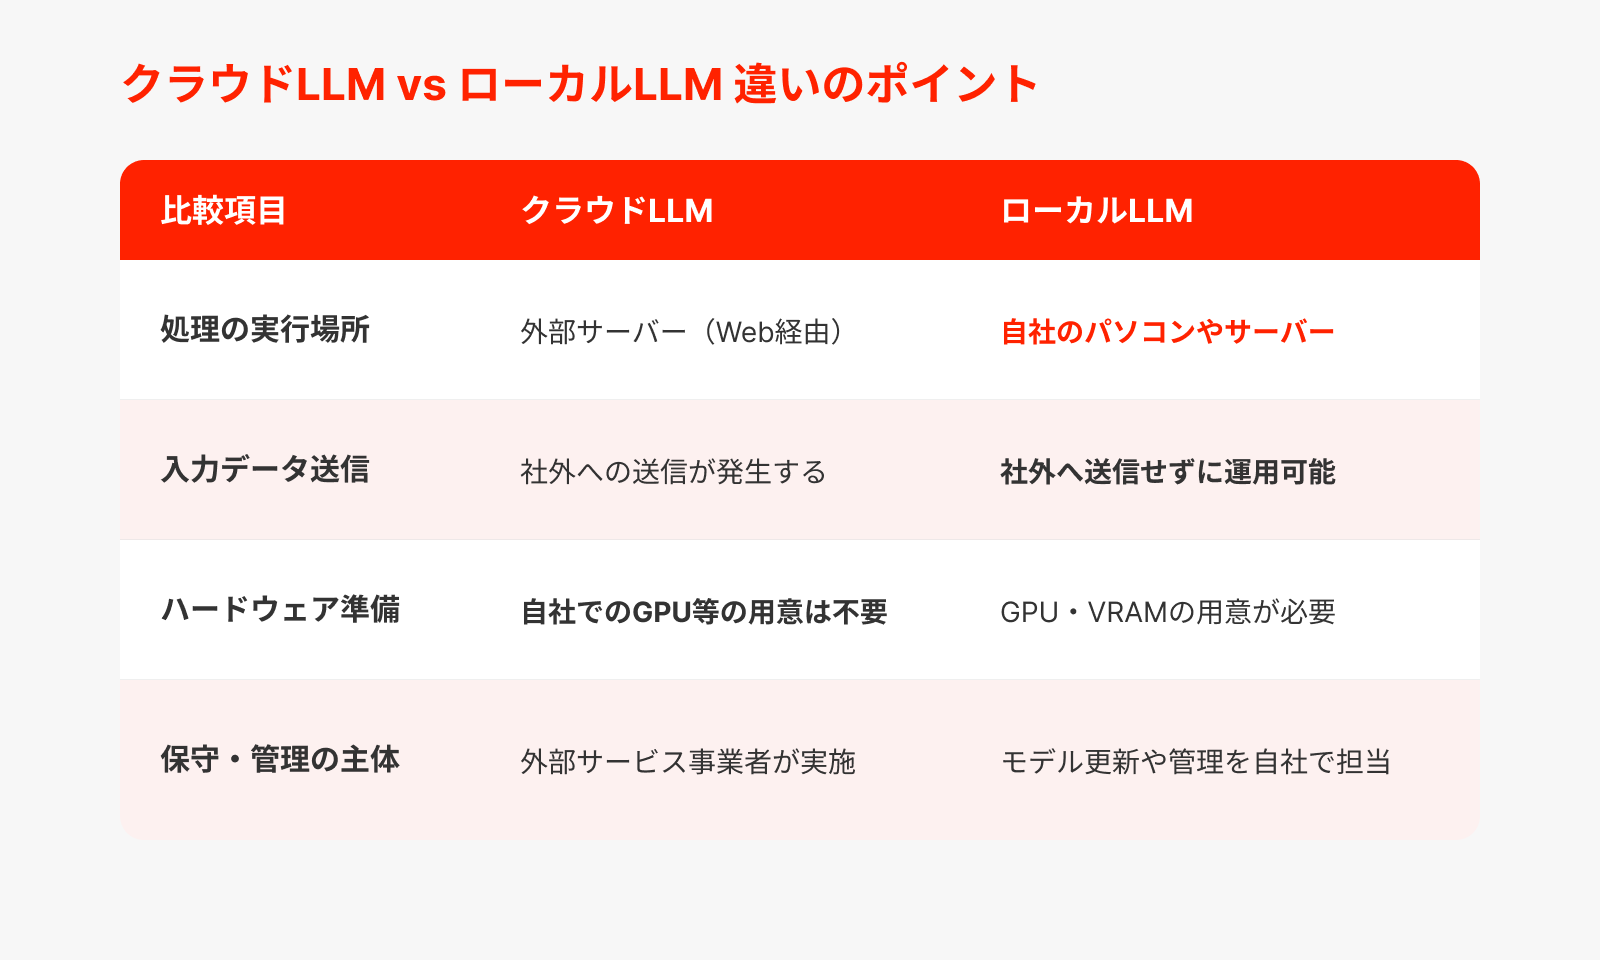
ローカルLLMとクラウドLLMでは、AIの処理を行う場所が異なります。クラウドLLMはインターネット経由で外部サーバー上のモデルを利用するのに対し、ローカルLLMは自社のパソコンやサーバー上で処理します。ローカルLLMは入力データを社外へ送信しない構成を取りやすく、機密情報を扱う業務にも利用できます。
一方、クラウドLLMは自社でGPUなどの処理環境を用意する必要がなく、必要なときに高性能なモデルを利用できます。ローカルLLMでは、ハードウェアの準備やモデルの更新、保守などを自社で担う必要があるため、導入時はセキュリティだけでなく、運用負担やコストも含めて考える必要があります。
企業がローカルLLMを導入するメリット
ここでは、企業がローカルLLMを導入するメリットを4つ紹介します。
併せて読みたい:業務システム×AI活用ガイド|活用事例と導入計画の立て方を紹介
機密情報を社外に送信しない構成
ローカルLLMは、自社のパソコンやサーバーなどで処理できる仕組みです。社内文書や顧客情報などを外部サービスへ送信せずに扱えるため、機密情報を扱う業務にも利用できます。
社内文書を活用した回答生成
ローカルLLMでは、社内規程や製品マニュアル、過去の問い合わせ履歴などを活用した回答生成が可能です。社内情報をもとに回答するFAQや、文書の検索・要約などにも活用できます。
利用量が増えてもAPI費用が増えない
ローカルLLMは、クラウドLLMのようなAPIの従量課金がなく、利用量が多くても費用を管理しやすくなります。サーバーやGPUなどの設備を用意することで、継続的なAI利用に対応できます。
業務システムと連携したAI活用
ローカルLLMは、社内データベースや業務システムと組み合わせて、業務に応じた使い方も可能です。社内データの検索や要約、問い合わせ対応など、既存の業務フローにAIを組み込めます。
ローカルLLM導入時の注意点
ここでは、ローカルLLMを導入する際の注意点を紹介します。
併せて読みたい:アプリ開発のセキュリティ対策とは?情報漏洩を防ぐ設計と管理のポイント
GPU・VRAMへの初期投資
ローカルLLMでは、モデルの規模に応じて高性能なGPUや十分なVRAMが必要になります。既存のパソコンでは処理できないモデルもあるため、用途に合ったスペックを選び、機器の購入費や電気代なども含めて導入コストを見積もります。
モデル更新や権限管理の運用負担
ローカルLLMは、モデルの更新やセキュリティパッチの適用などを自社で管理します。ユーザーへの教育やガイドラインの整備も含め、導入後の運用体制をあらかじめ整えておきます。
回答品質と情報漏えいへの対策
ローカルLLMは、モデルによって日本語性能や推論能力などが異なります。用途に合ったモデルを選び、実際の業務データを使って、回答品質を検証します。また、機密情報を扱う場合は、端末やネットワークの管理も欠かせません。
社内アクセス権限とログ管理
ローカルLLMを社内で利用する際は、ユーザーや部署ごとのアクセス範囲を適切に設定する必要があります。入力データや生成結果のログについても管理方法を決め、誰がいつ利用したのかを追えるようにしておきましょう。
業務向けローカルLLMを選ぶ5つのポイント
ここでは、業務で利用するローカルLLMを選ぶ際に確認したい5つのポイントを解説します。
1. 用途を明確にする
まず、ローカルLLMをどの業務で使うのかを具体化します。文書作成や要約なら汎用モデル、コード生成ならコーディング向けなど、用途によって適したモデルは異なります。求める精度や応答速度もあわせて整理しましょう。
2. 日本語性能を確認する
日本語で業務に使う場合は、対応言語の数だけでなく、文章の自然さや正確さも確認します。候補を絞ったら、自社の製品名や専門用語などを含む質問を用意し、実際の業務に近い環境で回答品質を比べると判断しやすくなります。
3. パラメータ規模とVRAMを確認する
モデルのパラメータ規模が大きくなるほど、一般に必要なVRAMも増えます。手持ちのGPUで動作するかを確認し、導入するモデルに合ったハードウェアを選びましょう。量子化モデルを使えば、必要なVRAMを抑えられる場合もあります。
4. 商用利用の条件を確認する
公開されているモデルでも、商用利用や改変、再配布などの条件は一律ではありません。業務で利用する前に公式サイトで自社の利用目的が条件にあっているかを確認しましょう。
5. 量子化による容量と性能の変化を確認する
量子化は、モデルのデータ量を圧縮し、少ないVRAMでも動作させやすくする技術です。Q4やQ5など圧縮の度合いによって容量と回答品質が変わるため、利用するGPUの性能と求める精度を踏まえて選びます。
用途別に見るローカルLLMの候補
ここでは、用途別にローカルLLMの候補を紹介します。
※2026年10月時点の情報です。
gpt-oss・Gemma 4|軽量な汎用モデル
比較的限られた環境で汎用LLMを試すなら、gpt-oss-20bやGemma 4が選択肢に入ります。gpt-oss-20bは21BパラメータのMoEモデルで、推論時に稼働するのは3.6Bです。Gemma 4にもE2BやE4Bなどの小型モデルがあり、ノートパソコンからサーバーまで環境に応じて選べます。
Qwen3.5|日本語対応の汎用モデル
日本語を含む複数言語で、文書作成や要約など幅広い業務に使う場合は、Qwen3.5が候補になります。モデルサイズに幅があるため、GPUの性能や用途に合わせて規模を選びやすい点も利点です。実際の業務文書を使って回答を試せば、自社での適性を判断する材料になります。
Qwen3.6-35B-A3B|コーディング向けモデル
プログラムの生成やコードレビューなど、開発業務との連携を重視する場合に候補となるモデルです。35B規模のMoE構成で、推論時のアクティブパラメータは約3Bです。Apache 2.0ライセンスで公開されているため、商用利用を含めたライセンス条件を確認したうえで、自社の開発業務への利用を検討できます。
ELYZA・Sarashina|日本語特化モデル
日本語の文章処理を優先するなら、ELYZAやSarashinaも検討しましょう。Llama-3-ELYZA-JP-8BはLlama 3をベースにした8Bパラメータの日本語モデルです。Sarashina2.2-3Bは日本語と英語に対応しており、日本語中心の業務で比較対象に加えられます。ライセンスは、Llama-3-ELYZA-JP-8BがMeta Llama 3 Community License、Sarashina2.2-3BがMIT Licenseです。
ローカルLLMに必要なパソコンのスペック
ローカルLLMを動かすパソコンは、利用するモデルの規模や量子化方式、処理する文章の長さに応じて選びます。特に確認したいのが、GPUのVRAMとメインメモリ(RAM)の容量です。モデルをメモリに読み込めない場合は、起動できなかったり、処理速度が低下したりすることがあります。
目安として、7B〜8B程度の4bit量子化モデルならRAMは16〜32GB程度、14Bでは32〜64GB程度、32Bでは64〜96GB程度を検討します。70B級では96〜128GB程度が一つの目安です。GPUで処理する場合は、モデルの規模だけでなく、推論時のメモリ消費も考慮してVRAMを選びましょう。
また、モデルの保存にはSSDを使用するため、複数のモデルを扱う場合は容量にも余裕を持たせます。WindowsやLinuxではNVIDIA製GPUを利用する構成が選択肢となり、MacではApple Siliconのユニファイドメモリを活用できます。
必要なスペックはモデルや実行環境によって変わります。導入前に候補モデルを実際に動かし、応答速度やメモリ使用量を確認したうえで構成を決めましょう。
ローカルLLM導入を成功させる4つのステップ
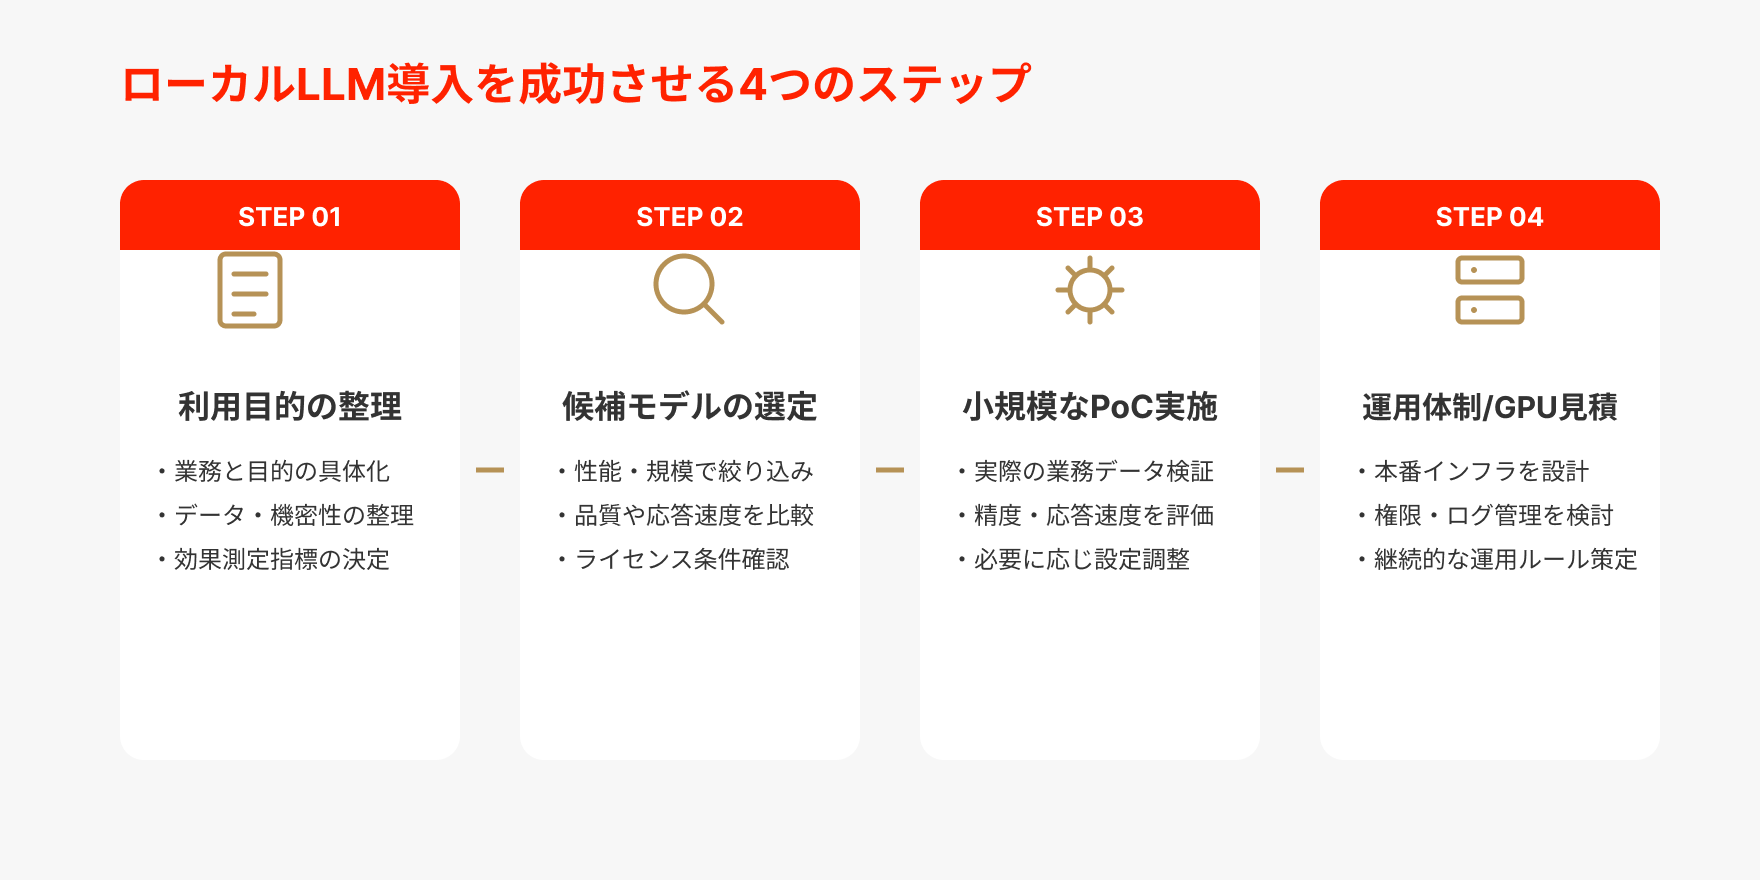
ここでは、ローカルLLMを導入する際の4つのステップを紹介します。
ステップ1. 利用目的の整理
まず、ローカルLLMを活用する業務と目的を明確にします。「社内文書を検索する」「報告書を要約する」など、対象業務を具体化しましょう。入力データやユーザー数、処理量、情報の機密性も整理し、問い合わせ対応時間など、導入効果を測る指標を決めておきます。
ステップ2. 候補モデルの選定
次に、用途や日本語性能、モデル規模、ライセンスを基準に候補を絞ります。最初から大規模モデルに限定せず、軽量なモデルも含めて比較すると、必要以上の計算資源を用意せずに済みます。候補を2〜3個に絞り、同じデータと質問を使って回答品質や応答速度を比べましょう。商用利用や再配布などの条件も、この段階で確認します。
ステップ3. 小規模なPoCの実施
候補モデルを既存のパソコンや小規模な環境で動かし、実際の業務データを使って検証します。回答の正確性だけでなく、応答速度やメモリ使用量、担当者による確認時間なども評価対象です。課題が見つかった場合は、モデルや量子化方式、データの与え方などを調整し、同じ条件で再度検証します。
併せて読みたい:生成AIにおけるPoCとは?手順・注意点・外注先選びまで徹底解説
ステップ4. 運用体制とGPUの見積もり
PoCの結果をもとに、利用者数や同時アクセス数、求める応答速度を踏まえて本番環境を設計します。GPUやサーバーの構成だけでなく、モデル更新、アクセス権限、ログ管理、障害時の対応方法も検討が必要です。担当者や管理ルールまで決めて、継続的に運用できる体制を整えましょう。
併せて読みたい:システム開発の外注 vs 内製を徹底比較|メリット・デメリット、費用感と契約(請負/準委任)、成功手順まで解説
まとめ
ローカルLLMは、社内文書の検索や要約、業務システムとの連携など、さまざまな業務に活用できます。導入時は、用途や必要な性能を整理し、適したモデルやパソコンのスペックを選びましょう。
一方で、GPU・VRAMの確保やモデルの更新、アクセス権限、ログ管理など、導入後の運用まで考慮する必要があります。最初から大規模な環境を構築せず、小規模なPoCで回答品質や処理速度を検証してから、本番環境の構成を決めましょう。
ローカルLLMの導入や業務システムとの連携を自社だけで進めることに不安がある場合は、AI開発の専門家に相談しながら進める方法もあります。お困りごとやご相談がある場合はお気軽にSun Asteriskまでお問い合わせください。